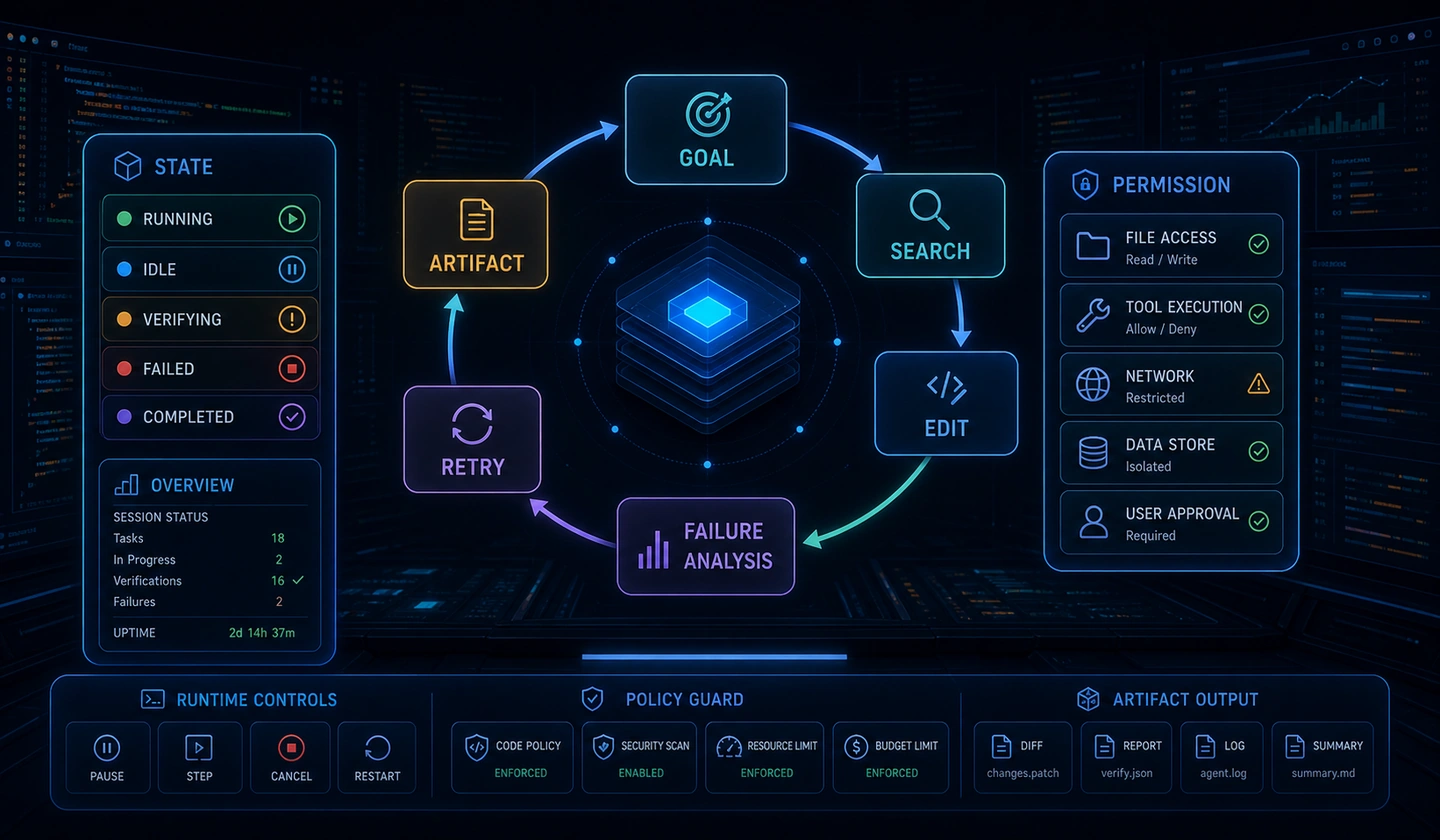
본 포스트는 'AI 에이전트 엔지니어링(AI Agent Engineering)' 시리즈의 1편입니다. 단순한 단발성 ChatCompletion API 호출에서 벗어나, 목표(Goal)를 달성하기 위해 자율적으로 상태를 갱신하고 도구를 실행하는 에이전트 런타임 및 아키텍처를 다룹니다.
1. 프롬프트 호출 vs AI 에이전트 런타임
이 글에서는 AI 에이전트를 실행 루프와 상태를 유지하는 런타임으로 설명합니다.
도식을 글로 읽기
단발성 경로는 User Input에서 LLM Prompt API를 거쳐 Static Response로 끝납니다. 별도 에이전트 경로는 User Goal, Observe의 환경·상태 관찰, Plan의 과업 분해·추론, Act의 도구 실행·환경 변화, 목표 달성 검증 순서입니다. 미달성이면 Observe로 돌아가 재계획하고 달성 또는 한계 초과면 Final Answer 또는 Safe Exit로 끝납니다.
에이전트 엔지니어링은 응답 이후의 실행도 다룹니다. 실패 감지, 계획 수정, 다음 도구 호출, 종료 조건을 런타임에서 제어해야 합니다.
아키텍처 구조 비교
| 비교 항목 | 단발성 LLM 프롬프트 호출 | AI 에이전트 런타임 (Agent Loop) |
|---|---|---|
| 제어 메커니즘 (Control Flow) | 단방향 파이프라인 (Input → Prompt → LLM → Output) | 동적 순환 제어 루프 (Observe → Plan → Act → Verify) |
| 상태 관리 (State Management) | Stateless (단일 요청 내 상태 유지 불가) | Stateful (메모리, 실행 이력, 환경 피드백 지속 갱신) |
| 도구 연동 (Tool Usage) | 불가능 또는 단순 Function Call 1회 조합 | 복수 도구 체이닝 및 결과에 따른 동적 Re-planning |
| 예외 복구 (Fault Tolerance) | API 실패 시 요청 전체 실패 (Deterministic Error) | 도구 실패 감지 시 대체 실행 경로 추론 (Self-Healing) |
| 복잡한 과업 수행 | 단일 프롬프트 용량 한계로 정밀도 급감 | 과업 분해(Task Decomposition)를 통한 계층적 처리 |
| 비용 및 지연시간 (Latency) | 예측 가능 (단일 Call 토큰 비용 및 Latency) | 실행 루프 횟수 및 추론 경로에 따라 변동성 존재 |
2. Observe-Plan-Act 패러다임과 과업 분해 (Task Decomposition)
복잡한 요구사항을 단 한 번의 LLM 프롬프트로 해결하려 하면 추론 정확도가 급격히 떨어집니다. 에이전트 아키텍처에서는 이를 과업 분해(Task Decomposition) 메커니즘을 통해 다단계 서브 타스크로 분할합니다.
Observe-Plan-Act 상태 머신 (State Machine)
Observe·Plan·Act는 내부 단계를 가진 복합 상태입니다. 먼저 내부 진행을 구분합니다. 각 상태의 진입점은 해당 상태 안에서만 해석합니다.
| 복합 상태 | 내부 출발 | 내부 도착 | 처리 |
|---|---|---|---|
| Observe: 관찰 | 진입점 | ReadEnvironment | 환경 읽기 시작 |
| Observe: 관찰 | ReadEnvironment | UpdateState | 도구 실행 결과·피드백 동기화 |
| Plan: 계획·과업 분해 | 진입점 | AnalyzeGoal | 목표 분석 시작 |
| Plan: 계획·과업 분해 | AnalyzeGoal | DecomposeSubtasks | 의존성 그래프·서브타스크 분할 |
| Plan: 계획·과업 분해 | DecomposeSubtasks | SelectNextAction | 바인딩 도구·실행 우선순위 결정 |
| Act: 행동·도구 실행 | 진입점 | InvokeTool | 도구 호출 시작 |
| Act: 행동·도구 실행 | InvokeTool | CaptureResult | 도구 반환값·에러 수집 |
상태 사이의 이동은 다음 전이표를 따릅니다. Evaluate는 네 결과로 갈라지는 판정 지점입니다.
| 현재 상태 | 조건·처리 | 다음 상태 |
|---|---|---|
| 시작점 | 목표(Goal) 수신 | Idle |
| Idle | 초기 상태·환경 컨텍스트 수집 | Observe |
| Observe | 관찰 컨텍스트 준비 완료 | Plan |
| Plan | 실행 준비 완료 | Act |
| Act | 관찰 결과 피드백 전달 | Evaluate |
| Evaluate | 성공: 다음 서브타스크 진행 | Observe |
| Evaluate | 도구 실패·예외: 재계획 | RePlan |
| Evaluate | 모든 서브타스크 완료: 목표 달성 | GoalAchieved |
| Evaluate | 루프·자원 한계 초과: 추론 경계 이탈 | BoundaryExceeded |
| RePlan | 계획 수정·전략 재설정 | Plan |
| GoalAchieved | 최종 답변 반환: Success Exit | 종료점 |
| BoundaryExceeded | 폴백·Human-In-The-Loop: Safe Exit | SafeExit |
| SafeExit | 안정적 시스템 종료 | 종료점 |
Pydantic을 활용한 과업 구조화: LLM의 자유 형식 텍스트 출력 대신 Strict JSON Schema나 Pydantic 모델을 강제하면, 과업 분해 결과를 파이썬 런타임에서 안전하게 파싱하고 상태를 추적할 수 있습니다.
from typing import List, Optionalfrom pydantic import BaseModel, Field class SubTask(BaseModel): id: int description: str tool_name: Optional[str] = Field(default=None, description="실행에 필요한 도구 이름") status: str = Field(default="pending", description="pending | in_progress | completed | failed") class ExecutionPlan(BaseModel): goal: str subtasks: List[SubTask] reasoning: str과업 분해 트리 (Task Decomposition Tree)
계층적 과업 분해를 통해 복잡한 목표가 개별 도구 호출 및 상태 변경 단위로 구체화되는 과정입니다.
최상위 Goal은 “웹 트래픽 데이터 수집 및 비정상 트랜잭션 분석 보고서 작성”입니다. 과업 분해 트리 아래에 세 Task가 속하며, 각 Task는 자신의 도구와 상태로 이어집니다.
| Goal에 속한 Task | 작업 | 연결된 Tool | Tool 이후 상태 |
|---|---|---|---|
| Task 1 | API 로그 데이터 조회 | fetch_api_logs(date='2026-07-21') | completed |
| Task 2 | 앙상블 탐지 로직으로 이상치 검출 | detect_anomalies(df, threshold=3.0) | in_progress |
| Task 3 | 종합 요약 보고서 작성 | generate_markdown_report(summary) | pending |
Task 1의 completed 상태는 관찰 결과를 전달해 Task 2의 의존성을 만족합니다. Task 2의 상태에서 Task 3으로 향하는 의존성은 아직 만족 예정입니다. 진행 중인 작업을 완료된 것으로 읽지 않습니다.
1) Plan (계획)
목표를 전달받은 모델은 목표 달성을 위한 서브 타스크의 종속 관계를 분석하고 정형화된 스키마 형태로 실행 계획(ExecutionPlan)을 수립합니다.
2) Observe & Act (관찰과 실행)
각 서브 타스크를 하나씩 실행(Act)하며, 결과값이나 외부 API 반환값을 상태 배열에 기록(Observe)합니다. 만약 의도치 않은 반환값이 나오거나 도구 에러가 발생하면 계획을 즉시 수정(Re-planning)합니다.
3. 추론 경계 (Reasoning Boundary)와 탈출 조건
프로덕션 환경에서 에이전트를 운용할 때 가장 위험한 패턴 중 하나는 "무한 에이전트 루프(Infinite Agent Loop)"에 빠지거나, 모델이 불가능한 과업을 끝없이 재시도하는 현상입니다. 이를 방지하기 위해 반드시 추론 경계(Reasoning Boundary)를 설정해야 합니다.
무한 루프 방지: 에이전트에 명확한 루프 탈출 조건(Exit Condition)과 하드 리밋(Hard Limit)이 없으면, 비정상적인 반복 호출로 인해 무한 토큰 비용 지출과 API 블로킹이 발생할 수 있습니다.
확인할 방어 경계
| 방어 경계 (Boundary) | 임계값 예시 (Threshold) | 감지 방식 (Trigger Condition) | 조치 및 복구 (Fallback Action) | 시스템 안전성 영향 |
|---|---|---|---|---|
| 1. Max Iteration Limit | 10회 루프 | 단일 Goal 실행 당 누적 Loop 카운터 측정 | 루프 강제 종료 후 현재까지의 관찰 결과 기반 요약 반환 | 무한 루프 지출 차단 및 서버 리소스 보호 |
| 2. Context & Token Budget | Context Window 80% 달성 | 누적 프롬프트 토큰 및 Observation 길이 실시간 계산 | 히스토리 압축(Compression) 또는 핵심 State만 추출 후 중단 | LLM 토큰 초과 오류 방지 및 비용 상한선 설정 |
| 3. Repeated Tool Failure | 동일 Tool + 동일 Arg 3회 연속 실패 | Tool Execution Log 내 연속 실패 상태 및 Hash 비교 | 도구 호출 차단, 대체 도구 선택 강제 또는 Human-In-The-Loop(HITL) 요청 | 외부 API 장애 시 에이전트 맹목적 재시도 차단 |
Reasoning Boundary 시퀀스 흐름: 루프의 매 진입점마다 안전 경계 조건(Guard)을 검증하여, 조건 위반 시 LLM 호출을 차단하고 즉시 안전 탈출(Safe Exit) 경로를 탑니다.
Reasoning Boundary Exit 시퀀스 (Exit Sequence Diagram)
도식을 글로 읽기
사용자·시스템이 목표를 Agent Runtime Loop에 전달하면 Reasoning Boundary Guard가 루프 상태와 자원을 검증합니다. Max Loop 또는 Token Limit을 넘으면 Safe Exit·Fallback·HITL로 전환하고 안전 종료 결과를 반환합니다. 정상 실행이 허용되면 LLM Reasoner가 Tool 또는 External API를 호출하고 결과와 상태를 Runtime에 저장해 돌아갑니다.
Python 런타임 제어 코드 구현
# 에이전트 제어 루프의 안전 탈출 예시 (Python 런타임 개념)MAX_ITERATIONS = 10 def run_agent_loop(goal: str, state: AgentState) -> AgentResult: iteration = 0 while iteration < MAX_ITERATIONS: iteration += 1 # 1. 상태 관찰 및 대화 컨텍스트 구성 context = state.get_observation_context() # 2. LLM 추론 (Next Action 결정) action = llm_reason(goal, context) # 3. 종료 조건 검증 if action.is_final_answer: return AgentResult(success=True, output=action.final_output) # 4. Action 실행 및 오류 횟수 체크 result = execute_action(action) state.update(action, result) if state.consecutive_tool_failures >= 3: # 추론 경계 이탈 방지: 반복 실패 시 폴백 반환 return AgentResult(success=False, output="툴 지속 실패로 인한 Safe Exit") return AgentResult(success=False, output=f"최대 루프 횟수({MAX_ITERATIONS}회) 초과")4. 에이전트 아키텍처 설계 시 체크리스트
프로덕션용 에이전트 기본 구조를 설계할 때 아래 체크리스트를 확인하세요.
아래 체크리스트 항목 중 하나라도 누락되면, 프로덕션 환경에서 무한 루프, 토큰 오버플로우 또는 툴 호출 교착 상태가 발생할 위험이 커집니다.
| 영역 (Category) | 점검 항목 (Checklist Item) | 중요도 | 검증 방식 |
|---|---|---|---|
| 루프 안전성 (Loop Safety) | Max Iteration, Execution Timeout, Token Budget 하드 리밋이 적용되어 있는가? | CRITICAL | 런타임 미들웨어 / Guard Loop |
| 과업 검증 (Schema Validation) | Task Decomposition 및 Action Output이 Pydantic / Zod 스키마로 검증되는가? | HIGH | LLM Structured Outputs / Guardrails |
| 예외 복구 (Self-Healing) | 동일 도구 실패 시 Re-planning 경로 및 Safe Exit Fallback이 존재하는가? | HIGH | Retry Counter & Alternate Prompt Path |
| 상태 분리 (State Isolation) | LLM의 추론 텍스트와 실제 도구 Execution Context가 격리되어 관리되는가? | MEDIUM | Clean State Architecture / Memory Store |
5. 다음 포스트 예고
다음 회차 02편: 에이전트 메모리와 상태 관리에서는 에이전트의 단기 메모리와 장기 메모리 아키텍처, 그리고 복잡한 Graph 상태 스키마를 체계적으로 다루는 방법을 알아봅니다.
댓글
GitHub 계정으로 로그인하면 댓글을 남길 수 있습니다. 댓글은 GitHub Discussions를 통해 운영됩니다.